
11 Oct Cómo construimos un observatorio de salud pública con datos abiertos, y por qué la matemática importa más que el software
Bajada: En un año construimos dos observatorios hospitalarios con datos públicos: uno de España, con nueve años de serie y el costo de cada proceso, y otro de Colombia, con un solo año transcrito de PDF. La diferencia entre ambos no es de software: es de cuánto dato abre cada sistema de salud. Esto es lo que hay detrás: las tasas, las sumas de control, las discrepancias que encontramos y lo que hace falta para que un observatorio así sea real y no una demostración.
En Whatoko contamos por qué importa que 748.212 hospitalizaciones de 2025 fueran evitables. Aquí contamos cómo se construye el panel que lo muestra, hospcol.whatokohealth.io, porque la parte difícil no fue programarlo. Fue asegurarnos de que cada cifra que muestra sea exactamente la que publicó la fuente.
Los datos: públicos, pero no abiertos
ADRES publicó en julio de 2026 tres informes de su Dirección de Innovación y Analítica: presión del gasto hospitalario, hospitalizaciones evitables por condiciones sensibles a la atención primaria (HECSAP) y costo de oportunidad. Son excelentes. También son PDF. Las tablas que necesitábamos, 33 departamentos, 20 condiciones, 15 diagnósticos con sus 5 departamentos principales, 10 condiciones con su canasta ambulatoria, hubo que transcribirlas.
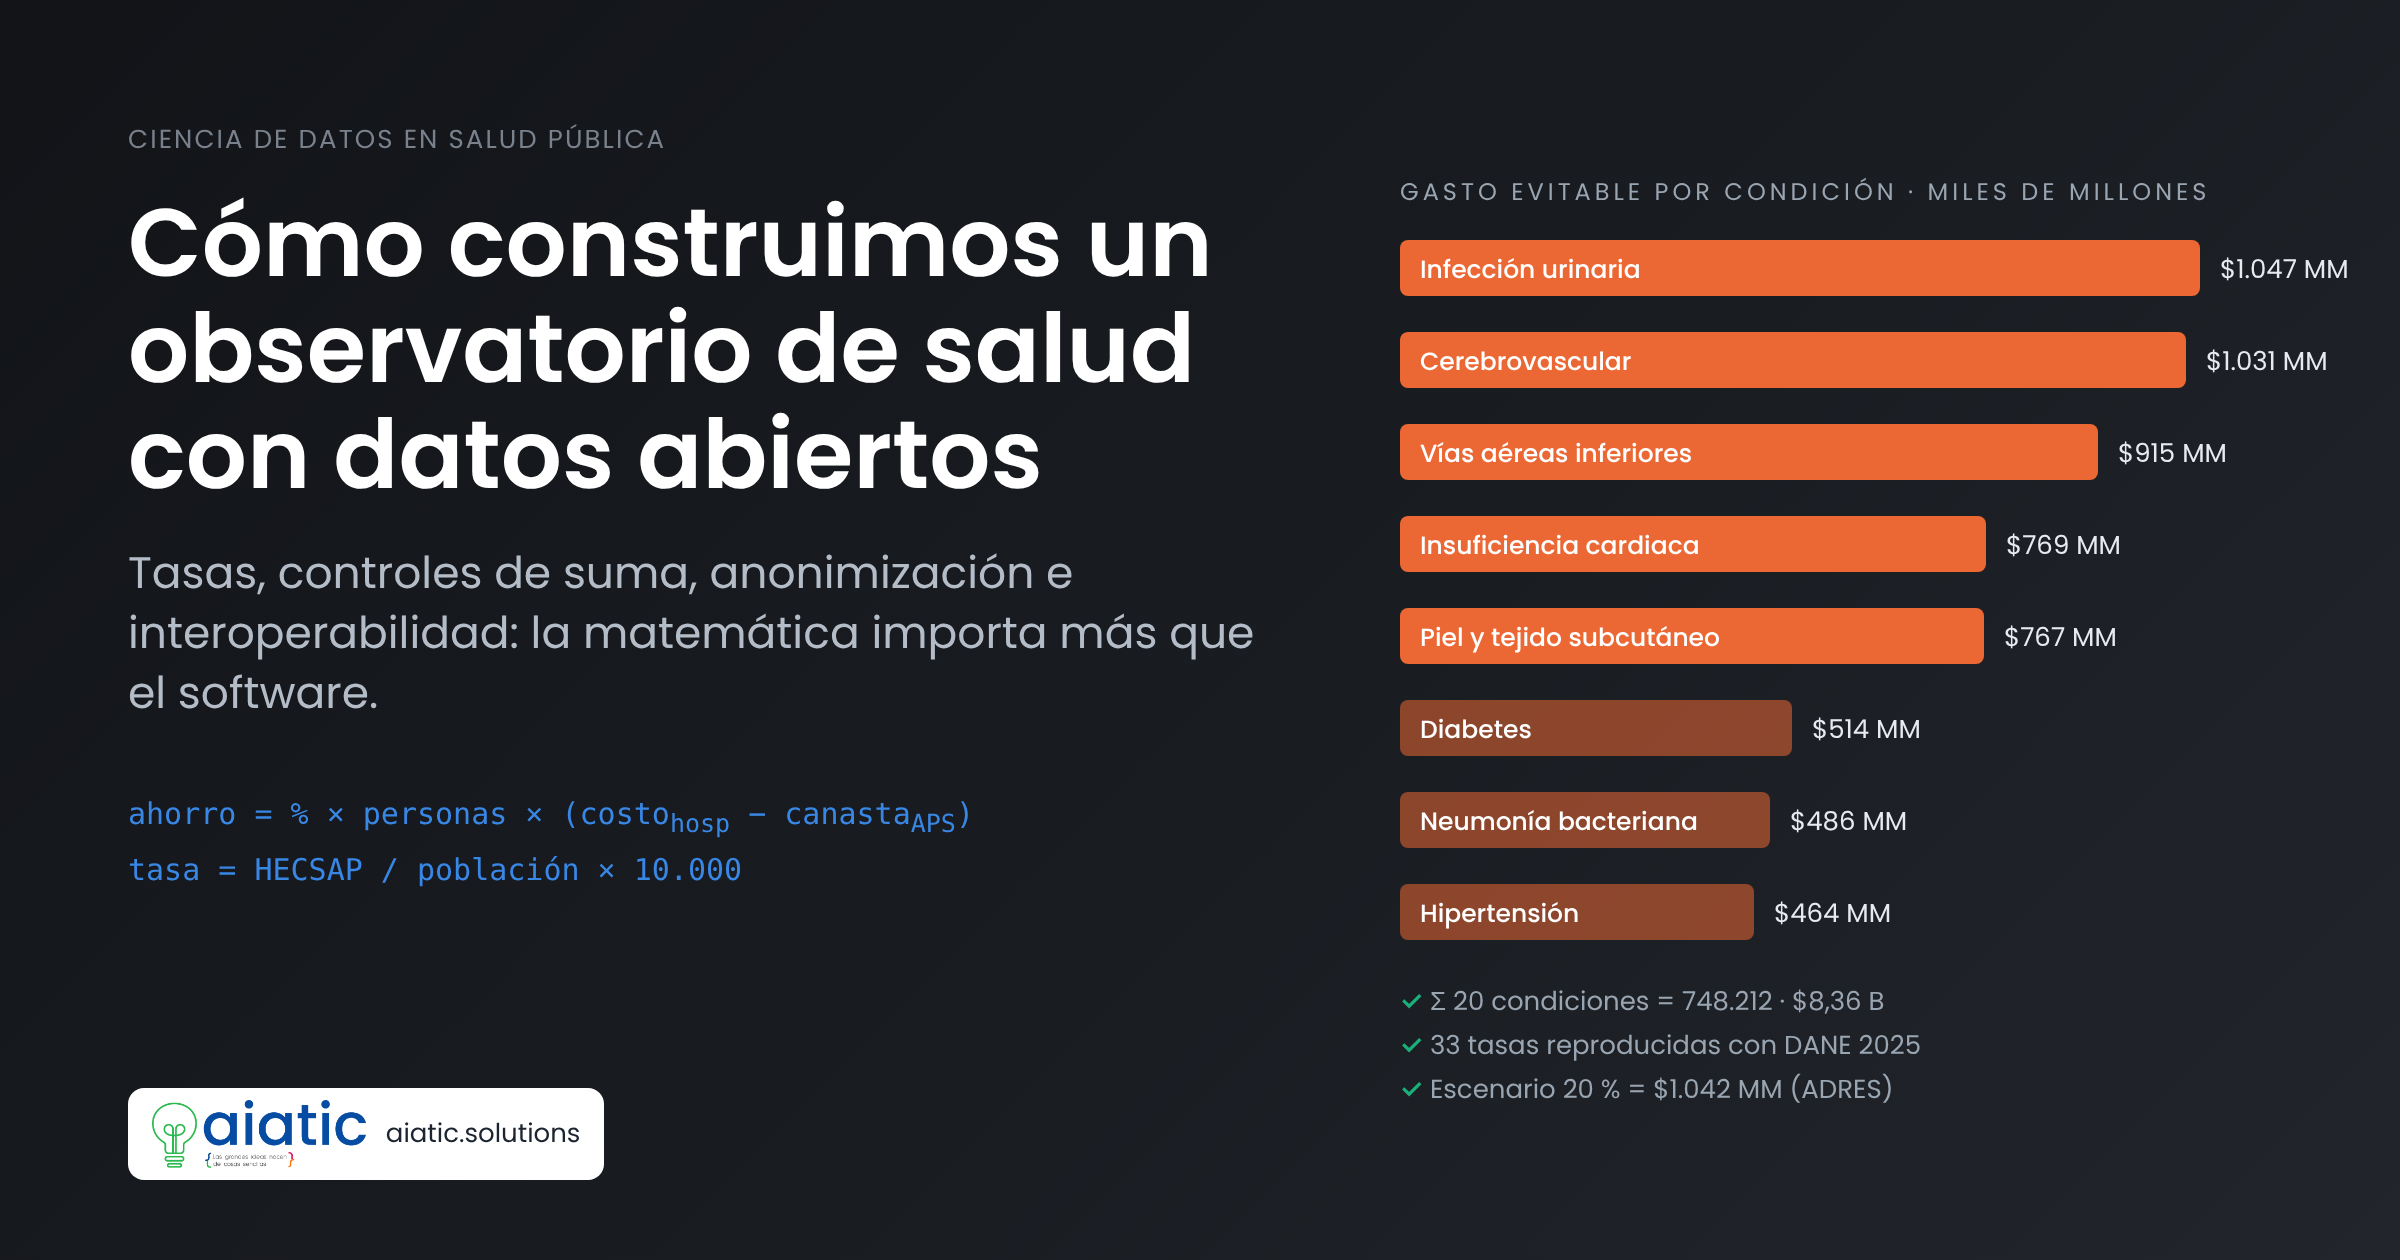
Transcribir es la operación más peligrosa de la ciencia de datos, porque el error no avisa. Por eso la primera regla del proyecto fue que ninguna cifra entra al panel sin un control que la reproduzca desde otra. Las 20 condiciones deben sumar 748.212 hospitalizaciones y 8,36 billones de pesos. El top 15 por gasto debe sumar lo que ADRES dice que suma. Las 33 tasas departamentales deben salir exactas al dividir las hospitalizaciones evitables entre la población DANE 2025 y multiplicar por 10.000. Todas pasaron, y los controles viven en el repositorio como un fichero controles.json que el código verifica en cada compilación.
La matemática que hay detrás
Un panel como este tiene poca estadística sofisticada y mucha aritmética honesta. Lo importante es saber qué mide cada número y qué no.
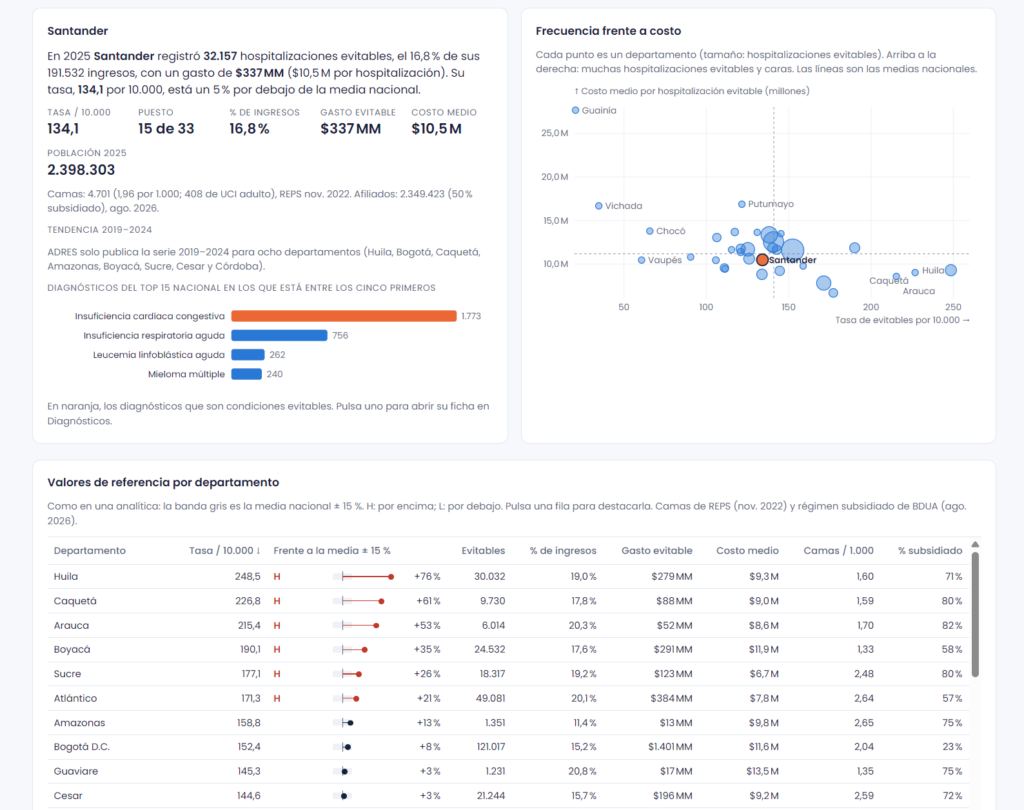
Tasas, no conteos. Bogotá tiene más hospitalizaciones evitables que Vaupés porque tiene más gente. Lo comparable es la tasa por 10.000 habitantes, y el denominador importa tanto como el numerador: usamos la proyección departamental del DANE a 2025, la misma serie que usó ADRES, y por eso las tasas reproducen la publicación al decimal.
Cuántas evitaría un departamento si bajara a la media. Es una resta: las hospitalizaciones evitables del departamento menos la media nacional multiplicada por su población. Para Huila, 30.032 menos 141 por 10.000 de 1,2 millones de habitantes: 12.989 ingresos al año. Es un contrafactual sencillo y hay que decirlo como tal.
Costo medio con y sin UCI. Un infarto cuesta en promedio 27,6 millones, pero ese promedio mezcla dos poblaciones: la que pasó por cuidado intensivo y la que no. Separarlas convierte un número opaco en dos que se entienden. La razón entre ambos es lo que llamamos intensidad del diagnóstico.
El escenario de ahorro. Es la fórmula de ADRES: ahorro = porcentaje de personas atendidas en primer nivel × personas × (costo de la hospitalización − costo anual de la canasta ambulatoria). Al 20 % da 1.042 mil millones, exactamente la cifra del informe, lo que nos confirma que entendimos bien las tablas. Pero es una cota superior: no descuenta lo que cuesta ampliar la atención primaria ni las hospitalizaciones que ocurrirían de todos modos. El panel lo dice al lado del número, no en una nota al pie.
Descomposición precio × volumen. Con las notas técnicas de la UPC de 2024 y 2026 (datos de 2022 y 2024) comparamos 15.889 códigos de procedimientos y medicamentos presentes en ambas. El gasto per cápita implícito pasó de 1,21 a 1,41 millones de pesos; 210.791 pesos de esa diferencia son efecto precio y −11.110 efecto volumen. Es la misma descomposición que usamos en el panel de costes hospitalarios de España, y la razón por la que los dos paneles comparten código.
Lo que no cuadra, se publica
Encontramos dos inconsistencias en la fuente. La columna de hospitalizaciones totales por departamento suma 4,4 millones, un 15 % más que los 3,83 millones del total nacional, probablemente porque no aplica la misma depuración. Y el porcentaje por diagnóstico de una tabla sale sistemáticamente un 17 % menor que el cociente calculado con otra. No las corregimos a nuestro criterio: las conservamos como publicadas, recalculamos la cuota con nuestras propias cifras, lo advertimos en la sección Método del panel y se lo preguntamos formalmente a ADRES. Un observatorio que esconde las dudas de sus datos no es un observatorio.
Dos observatorios, dos madureces del dato
Antes del panel colombiano construimos el de costes hospitalarios del Sistema Nacional de Salud de España, con la misma arquitectura. Ponerlos uno al lado del otro enseña más sobre política de datos que cualquier informe.
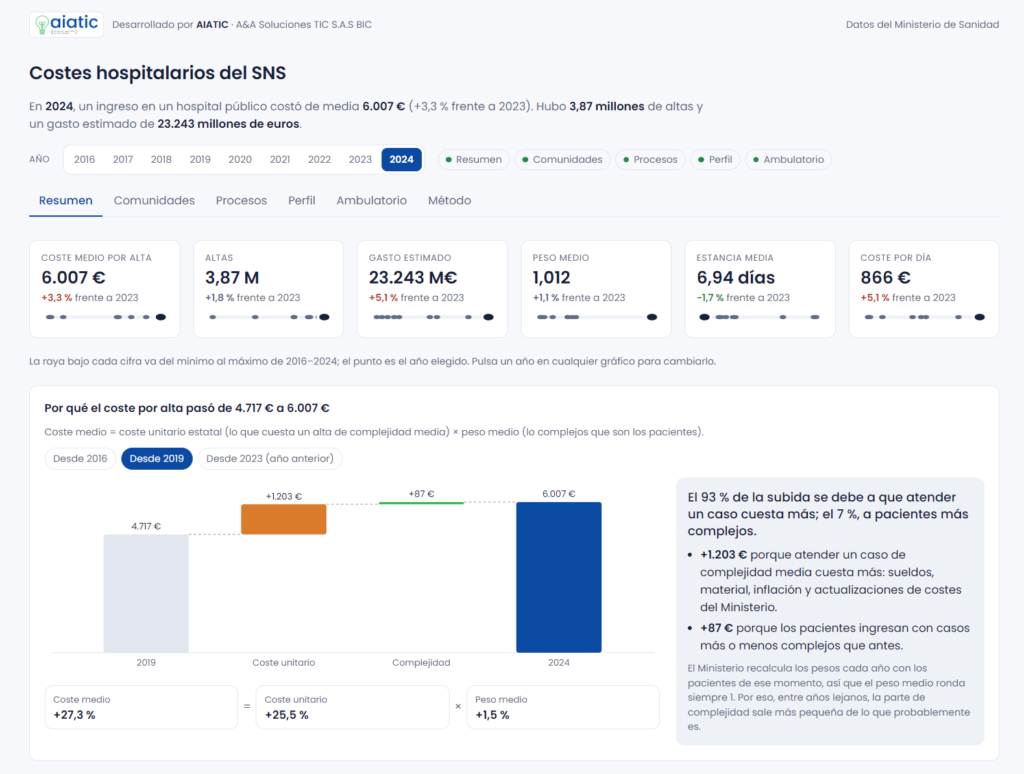
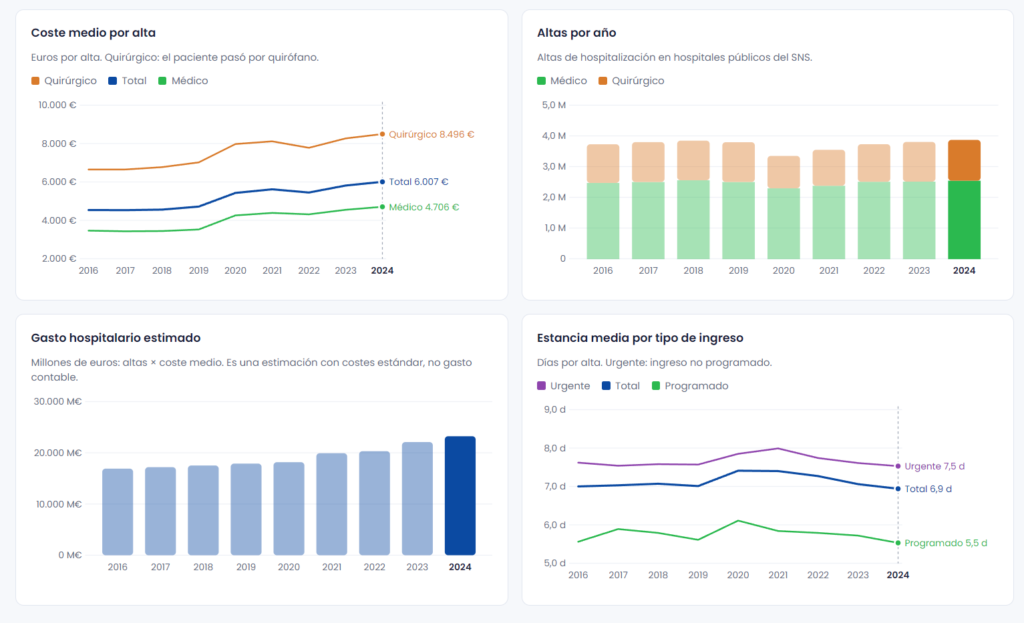
El Ministerio de Sanidad publica cada año, en un portal estadístico consultable, el registro de altas de todos los hospitales públicos (RAE-CMBD): 3,7 millones de altas en 2016, 3,9 millones en 2024, clasificadas en más de 300 grupos relacionados por el diagnóstico (APR-GRD), con cuatro niveles de severidad, peso relativo, estancia media y, desde 2023, el costo estimado de cada proceso, por comunidad autónoma, edad, tipo de ingreso y tamaño de hospital. Con eso el panel español responde preguntas que en Colombia hoy no se pueden ni formular: cómo pasó el costo medio por alta de 4.539 euros en 2016 a 6.007 en 2024 y qué parte de esa subida es precio y qué parte complejidad de los pacientes; cuánto cuesta una prótesis de cadera en Andalucía frente a Cataluña; cuántas veces más cuesta un parto con complicaciones severas que uno sin ellas; y qué procesos se podrían resolver de forma ambulatoria y a qué costo. Un filtro de año arriba refresca las cinco secciones, porque hay nueve años para elegir.
En Colombia el panel tiene un solo año, 2025, porque ADRES publicó por primera vez en julio de 2026 un análisis de este tipo a partir de la factura electrónica (FEV-RIPS), y lo hizo en tres PDF con tablas de dos páginas. No existe una clasificación oficial de procesos tipo GRD, no hay costo por diagnóstico más allá del top 15, no hay severidad y la serie 2019–2024 que existe viene de otra fuente (RIPS) y no es comparable en nivel. El registro individual de prestaciones (RIPS) está abierto en datos.gov.co, pero truncado y detenido en 2021. SISPRO, SIHO y SIRAS tienen el detalle, y no lo publican en formato abierto.
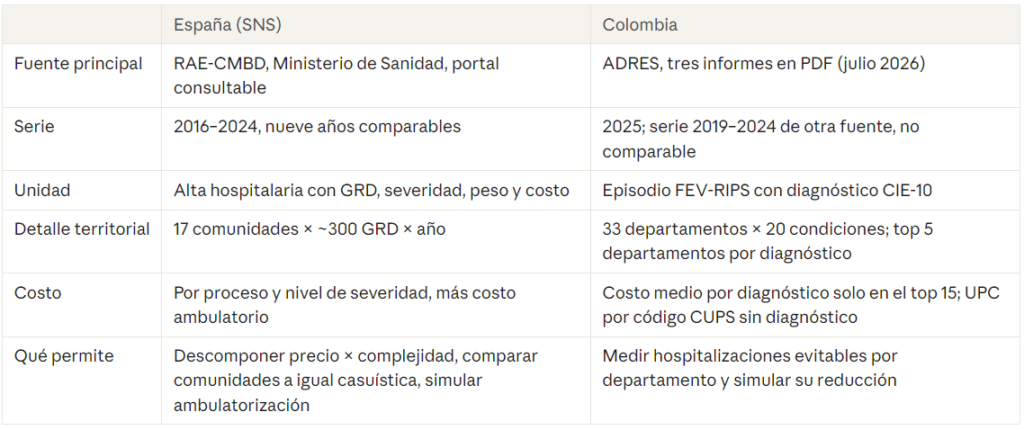
La lectura no es que España tenga mejor salud; es que tiene veinte años de registro unificado con una clasificación de procesos y un costo por alta que cualquiera puede consultar. Colombia tiene la factura electrónica, que en teoría es un registro más rico que el CMBD, pero solo ADRES la ve. Lo que un país abre determina lo que sus ciudadanos, sus secretarías de salud y sus investigadores pueden preguntar. Por eso los dos paneles comparten código y difieren tanto en profundidad: el software es el mismo; el dato no.
Anonimización: la condición, no el obstáculo
El panel no contiene datos personales porque trabaja con agregados publicados. Pero la versión que queremos construir, con datos de las secretarías y los hospitales, sí partirá de registros individuales, y ahí la anonimización es ingeniería, no un formulario de consentimiento. Tres reglas que aplicamos en nuestros proyectos de salud:
- Agregar antes de mover. Los datos individuales no salen de la entidad que los custodia. Lo que viaja es la tabla agregada: departamento × municipio × diagnóstico × grupo de edad × sexo. El procesamiento ocurre donde están los datos, con el código auditado por su dueño.
- Suprimir celdas pequeñas. Una celda con tres casos de una enfermedad rara en un municipio de 800 habitantes identifica a alguien aunque no tenga nombre. Toda celda por debajo de un umbral, típicamente cinco o diez, se suprime o se agrupa con la vecina, y los totales se ajustan para que la supresión no se pueda deshacer por diferencia.
- Documentar y versionar. Qué variables se cruzaron, qué umbral se usó, qué se suprimió y quién lo aprobó, con fecha. Es la base del cumplimiento de la Ley 1581 de 2012 de protección de datos y de la Ley 1712 de 2014 de transparencia, que no se contradicen: la primera protege al individuo, la segunda obliga a abrir lo agregado.
Interoperar es un problema de voluntad, no de tecnología
Para este panel cruzamos ADRES (FEV-RIPS), DANE (proyecciones de población), Minsalud (BDUA y REPS) y el manual tarifario SOAT. Cuatro fuentes, cuatro formatos, cuatro fechas de corte, ninguna clave común salvo el código DIVIPOLA del departamento. Unirlas fue un trabajo de normalización de nombres, de reagrupar distritos en su departamento, de decidir qué población usar como denominador. Nada de eso requiere tecnología nueva. Requiere que cada entidad publique en formato abierto, con un diccionario de datos y una clave de unión, y que exista alguien dispuesto a hacer el cruce.
Por eso el siguiente paso no es técnico: pedimos a ADRES sus tablas en XLSX y a la Secretaría de Salud de Santander el acceso a SIHO, el sistema de información de los hospitales públicos, con una propuesta de construir el mismo observatorio a escala departamental. Si cada entidad abre lo suyo, el observatorio se construye solo; si no, cada panel será una foto que envejece.
La ingeniería, en dos párrafos
El panel es una aplicación React con Vite y TypeScript, sin librerías de gráficos: usamos d3 solo para escalas y formas, y cada gráfico es SVG dibujado a mano, lo que permite controlar colores accesibles, modo oscuro y una paleta validada para daltonismo. Los datos van embebidos como JSON con su diccionario, de modo que actualizar el panel es sustituir un fichero y pasar los controles. El código vive en GitHub, se despliega en cada cambio y comparte armazón con el panel de costes hospitalarios de España, que construimos con la misma filosofía sobre los datos del Ministerio de Sanidad.
Lo construimos con ayuda de agentes de IA que escribieron buena parte del código, revisado sección por sección. Lo que no delegó nadie fue la lectura de las tablas, la definición de cada indicador y la decisión de qué advertir. Esa es la parte que convierte un dashboard en un instrumento de decisión.
AIATIC es una fábrica de software con certificación CMMI nivel 3, con sede en Bucaramanga. Whatoko Health es su línea de salud digital. Si tu entidad tiene datos y preguntas, hablemos.