
11 Oct Anonimización de datos de salud: el caso Saludtech Santander
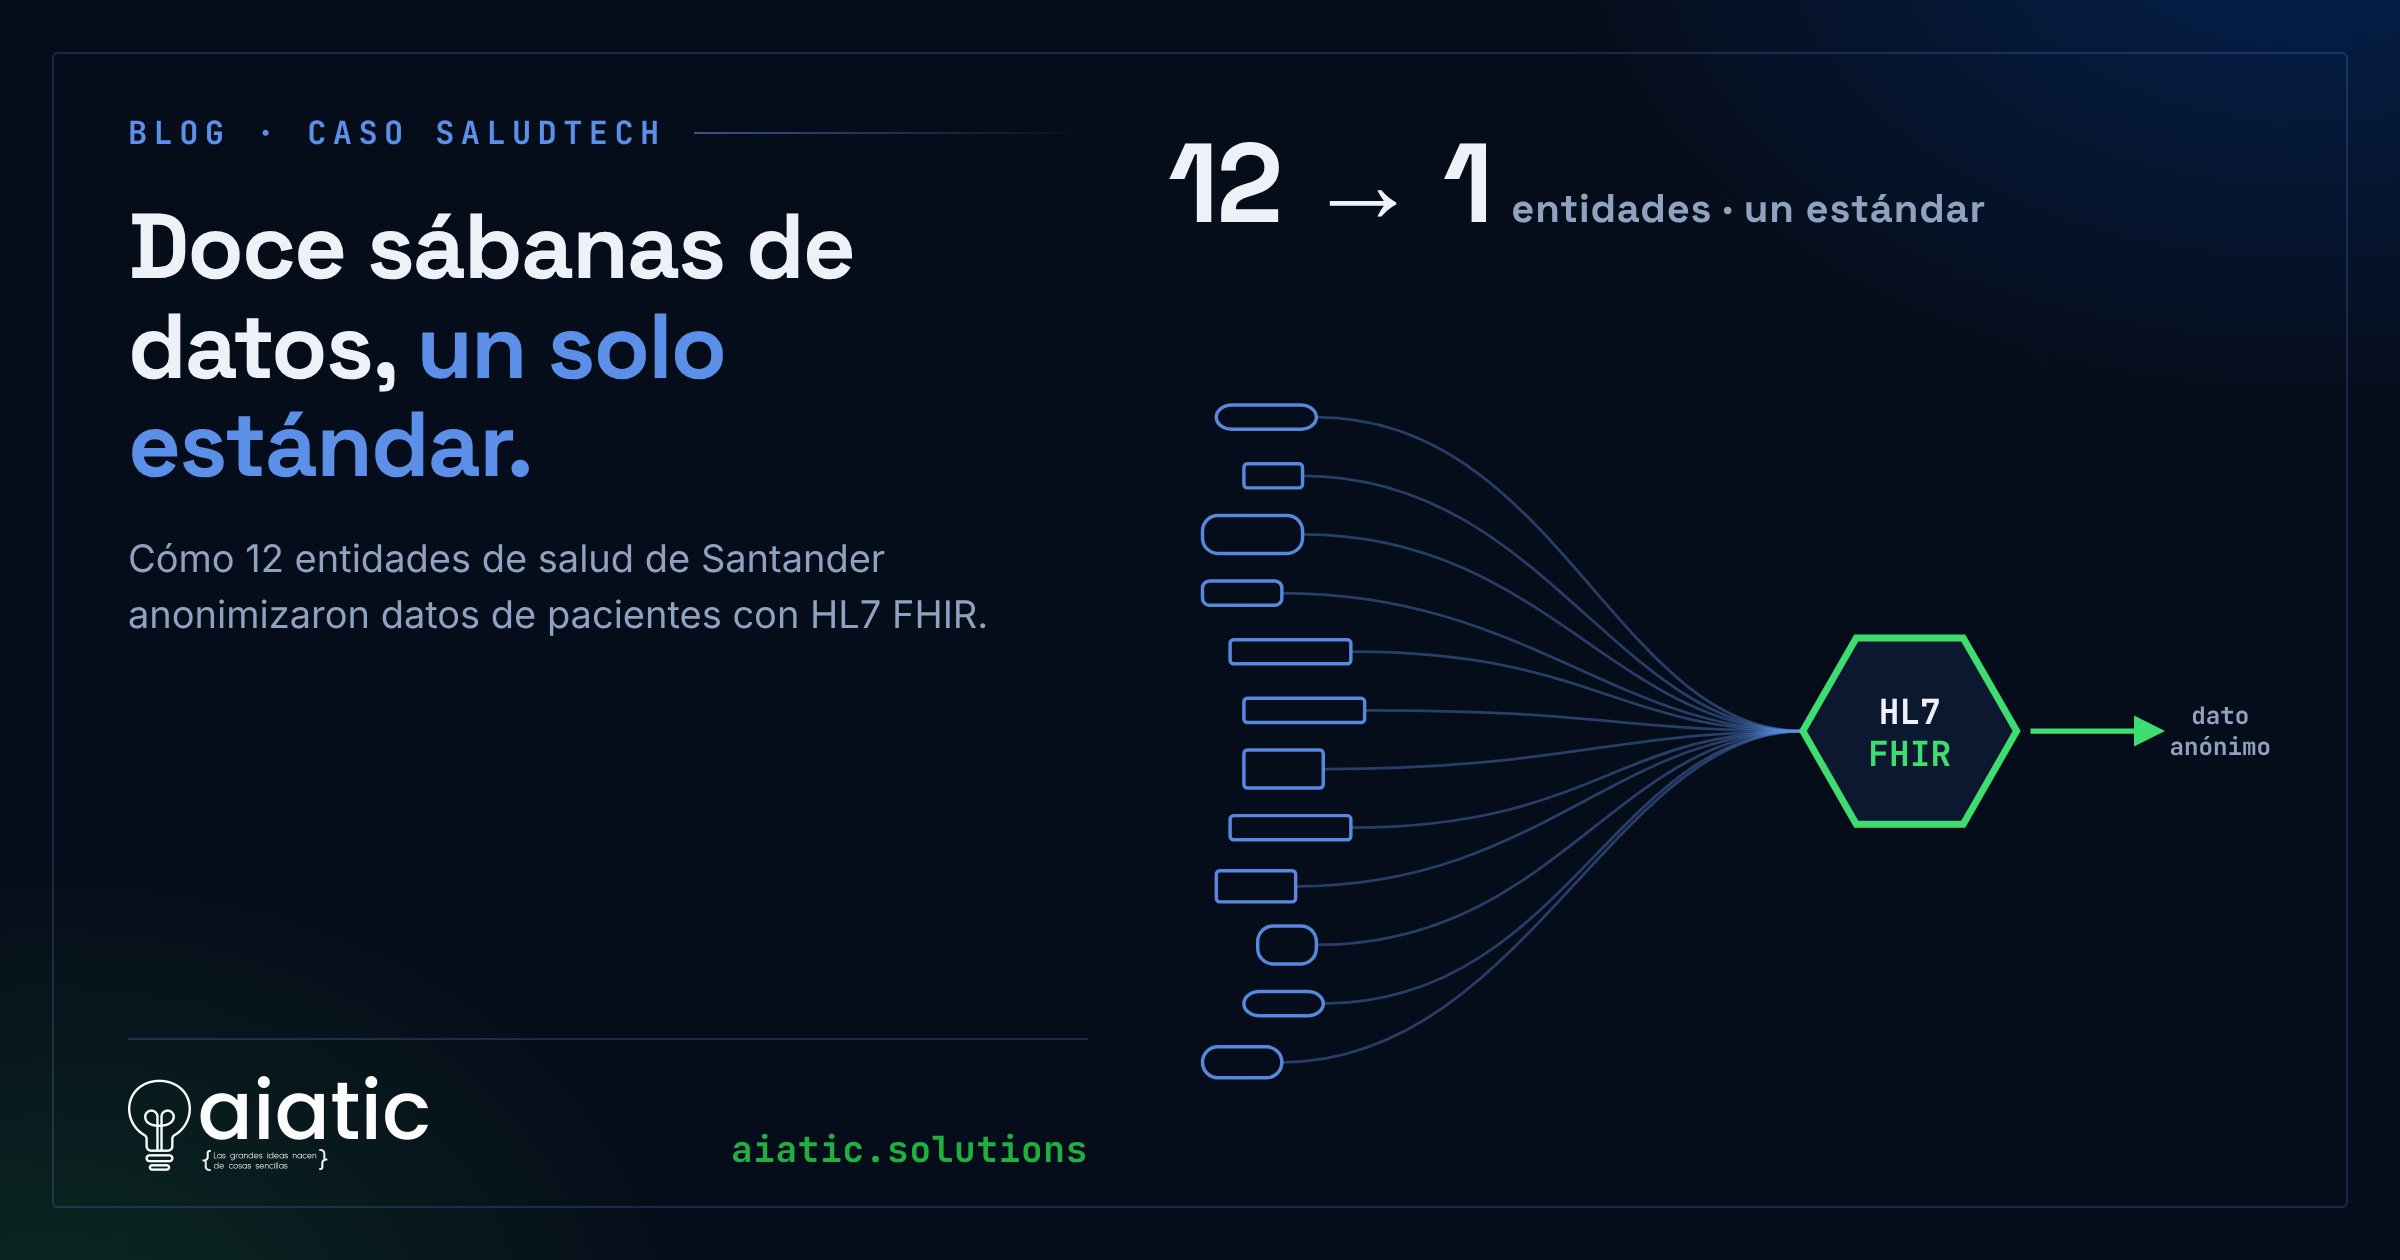
Doce entidades de salud de Santander, doce sábanas de datos totalmente distintas y un mismo objetivo: poder compartir información clínica sin exponer a un solo paciente.
Ese fue el punto de partida de Saludtech Santander, un programa de fortalecimiento de capacidades digitales del sector salud de la región, y el equipo de AIATIC estuvo a cargo de la consultoría y de la fábrica de software que lo hizo posible.
Este artículo cuenta el caso en cuatro tiempos: el problema, la ejecución, el resultado y lo que quedó después de la salida en vivo.
El problema: mucho dato clínico, poca madurez para usarlo
Saludtech Santander fue ejecutado por Colombia Productiva (Ministerio de Comercio, Industria y Turismo) y operado por la Cámara de Comercio de Bucaramanga y el Clúster Salud Santander, dentro de la estrategia Territorios Clúster. Su apuesta: que las instituciones de salud de la región fortalecieran la gestión automatizada de la información médica mediante la homogeneización y la anonimización de datos.
El reto tenía dos caras. La primera era de capacidades: cada entidad estaba en un punto distinto de madurez digital, con procesos, bases de datos y activos tecnológicos muy diferentes. La segunda era de coordinación: el proyecto debía movilizar a varias entidades del sector, de diversas especialidades, en un plazo ajustado. Un solo software no resuelve eso si cada institución llega a él sin preparación.
La ejecución: dos frentes en paralelo
El equipo decidió no esperar a tener el software terminado para empezar a trabajar con las entidades. Se atendieron dos frentes a la vez:
- Trabajo individual. Un diagnóstico de madurez digital por entidad, con una hoja de ruta propia para cerrar sus brechas. Las áreas que más pesaron fueron seis: gestión de compras de tecnología, activos digitales, trazabilidad de los datos, estandarización, interoperabilidad y administración de bases de datos.
- Trabajo grupal. Parámetros comunes para usar una única herramienta de anonimización de datos médicos de pacientes, con talleres y webinars sobre anonimización, gobierno de datos y omnicanalidad.
La secuencia fue esta: entre octubre y noviembre de 2024 se alistó el proyecto y se definió el alcance; entre diciembre de 2024 y enero de 2025 se hicieron los diagnósticos individuales; de febrero a agosto de 2025 cada entidad trabajó en su plan de cierre de brechas; y entre abril y agosto de 2025 se diseñó y desarrolló la solución técnica. En paralelo, entre abril y julio, cada entidad definió y alistó la sábana de datos que iba a anonimizarse.
La decisión de diseño más relevante
La plataforma recorre cuatro pasos simples: subir el archivo, revisar y asignar los campos, anonimizar y descargar. Y no custodia la información: los archivos quedan disponibles para descarga por unos pocos días y después se elimina la base de datos. Para un sector donde el dato del paciente es lo más sensible que existe, que la herramienta no guarde lo que procesa es una decisión de seguridad, no una limitación.
Interoperabilidad con un estándar abierto
La salida de la anonimización no se dejó a criterio de cada entidad. Se definió un estándar común para el manejo de la información y para el archivo que entrega el anonimizador, basado en HL7 FHIR, el estándar internacional de interoperabilidad en salud. Sin un estándar compartido, doce entidades producen doce formatos incompatibles; con uno, sus datos pueden compararse y analizarse en conjunto.
El resultado: cifras del proyecto
- 12 entidades de salud con capacidad de uso y aprovechamiento de un sistema de anonimización de datos médicos.
- 12 sábanas de datos totalmente diferentes procesadas por la misma herramienta.
- 1.387 tipos de datos mapeados de forma manual para definir sus reglas de calidad y de transformación.
- 6 recursos HL7 FHIR generados a partir de los tipos de datos que las doce entidades manejaban en conjunto.
- 13.500 pacientes con 110 datos cada uno por hora: el rendimiento del software, que anonimiza y transforma esa carga en una hora.
Además de la herramienta, el programa dejó capacidades instaladas: un parámetro individual para el cargue de información, gobierno de datos fortalecido en cada entidad beneficiaria, mejor apropiación de herramientas digitales y un estándar común para toda la región.
Qué pasó después: gobernanza y sostenibilidad
Un software entregado sin dueño ni reglas se desactualiza rápido. Por eso, entre julio y septiembre de 2025 el trabajo se concentró en la gobernanza y la sostenibilidad futura del producto resultante, con el acompañamiento del laboratorio U-Think Society Lab 5.0. En septiembre de 2025 llegó la salida en vivo, junto con la finalización de las consultorías, las pruebas técnicas y la socialización con las entidades.
El proyecto cerró con una pregunta abierta, y es la correcta: ¿qué sigue cuando el programa termina? Se sentaron las bases de interoperabilidad a nivel regional, se construyó un caso de estudio y se dejó definida la gobernanza de los datos y de la plataforma. Una hoja de ruta, una gobernanza y una guía metodológica: tres piezas pensadas para que el valor no dependa de que el programa siga financiado.
Qué aprendimos
- Primero procesos, después herramientas. Entender el flujo real de los datos de los pacientes antes de automatizar cualquier cosa evitó tecnificar un desorden.
- El software es la mitad del proyecto. La otra mitad es formación, gobierno de datos y un plan de trabajo que corra en paralelo al desarrollo.
- Un estándar abierto vale más que una buena herramienta. HL7 FHIR permitió que doce realidades distintas hablaran el mismo idioma.
- El dato sensible no se almacena si no hace falta. Diseñar la plataforma para no custodiar información redujo el riesgo desde el origen.
Preguntas frecuentes
¿Qué es la anonimización de datos de salud?
Es el proceso de transformar los datos clínicos de los pacientes para que no puedan vincularse con una persona identificable, conservando su utilidad para el análisis. Permite compartir y estudiar información de varias instituciones sin exponer la identidad de nadie.
¿Para qué sirve HL7 FHIR en una institución de salud?
HL7 FHIR es un estándar internacional para representar e intercambiar información clínica. Sirve para que sistemas distintos entiendan los mismos datos de la misma forma, que es la base de la interoperabilidad entre entidades de salud.
¿Por dónde empieza una entidad de salud que quiere mejorar su madurez digital?
Por un diagnóstico individual: entender cómo fluyen hoy sus datos, qué activos digitales tiene y dónde están sus brechas. Con ese mapa se define una hoja de ruta de corto plazo y se decide qué herramientas hacen falta, en ese orden.
¿Tu organización maneja datos sensibles que necesita compartir?
AIATIC es firma consultora y fábrica de software con certificación CMMI Nivel 3, y este tipo de proyecto, donde se mezclan diagnóstico, formación, gobierno de datos y desarrollo, es justo en el que mejor trabajamos. Si tu sector necesita interoperar sin comprometer información sensible, conversemos.
Agenda una conversación sobre datos, interoperabilidad y gobierno de datos →